Aperçu
La modélisation des données par IA est la discipline qui structure, relie et prépare les données d’entreprise afin que l’intelligence artificielle et les systèmes d’apprentissage automatique puissent les utiliser de manière fiable à grande échelle. Elle étend la modélisation traditionnelle des données — la conception conceptuelle, logique et physique des données — avec une couche spécifique à l’IA : caractéristiques, embeddings, structures vectorielles et la lignée requise pour une IA gouvernée.
À mesure que les entreprises passent de l’expérimentation en IA à la production, la qualité du modèle de données sous-jacent détermine de plus en plus la précision, l’explicabilité et la fiabilité des modèles. Lisez la suite pour une définition complète de la modélisation des données par IA, les quatre types utilisés dans les charges de travail en IA, les principes qui distinguent les données prêtes pour l’IA des données à usage général, une comparaison avec la modélisation traditionnelle des données, et la manière dont les entreprises leaders les abordent à grande échelle.
Qu’est-ce que la modélisation des données par IA ?
La modélisation des données par IA est le processus de structuration des données d’entreprise afin que les systèmes d’intelligence artificielle et d’apprentissage automatique puissent les consommer avec précision, cohérence et traçabilité. Elle englobe la conception conceptuelle, logique et physique des données — les mêmes trois couches qui sous-tendent la modélisation traditionnelle des données — ainsi qu’une couche supplémentaire dédiée aux fonctionnalités, embeddings et structures vectorielles dont dépendent les charges de travail de l’IA.
La modélisation en IA est souvent confondue avec deux concepts adjacents. La première est la modélisation traditionnelle des données, qui se concentre sur la représentation des entités métier, des attributs et des relations pour les applications, le reporting et l’analyse à usage général. La seconde concerne les modèles d’IA eux-mêmes — les grands modèles de langage, les réseaux de neurones et d’autres algorithmes qui consomment des données pour générer des prédictions ou des résultats. Ces modèles d’apprentissage automatique sont le produit ; La modélisation des données par IA est la préparation qui les rend possibles.
La modélisation des données par IA est le pont entre les deux. Il prend la rigueur de la modélisation traditionnelle — entités, relations, intégrité — et l’étend avec les structures, méthodes et gouvernance requises par les charges de travail d’IA. Sans cela, les initiatives d’IA stagnent sur des données d’entraînement peu fiables, des résultats inexplicables et des modèles qui ne peuvent être reproduits ni audités.
L’IA peut-elle faire de la modélisation des données ?
Oui — l’IA peut automatiser une partie importante de la modélisation des données, mais elle ne remplace pas cette pratique. Les outils de modélisation de données assistés par IA peuvent générer automatiquement des schémas à partir des systèmes sources, suggérer des relations entre entités, déduire des types de données et rétroconcevoir des bases de données existantes en modèles logiques. Ces capacités accélèrent de manière significative le travail mécanique de la modélisation.
Ce que l’IA ne peut pas faire, c’est valider la sémantique métier, appliquer des politiques de gouvernance ou déterminer quelles données comptent pour un cas d’usage donné. Un schéma généré par l’IA nécessite toujours un architecte humain des données pour confirmer que les entités reflètent le fonctionnement réel de l’entreprise, que les relations ont la bonne signification, et que le modèle sert le résultat analytique ou d’IA souhaité. En pratique, l’IA et les architectes humains des données travaillent de concert : l’IA supprime la surcharge répétitive, et l’architecte dirige la stratégie.
Les 4 types de modélisation des données utilisés pour l’IA
Les techniques de modélisation des données par IA évoluent de l’intention commerciale à une structure prête pour l’IA à travers quatre types. Les trois premiers sont familiers grâce à la modélisation traditionnelle des données ; le quatrième est spécifique à l’IA et c’est là que les entreprises sous-investissent le plus souvent.
Modélisation conceptuelle
La modélisation conceptuelle définit les entités de haut niveau, les relations et les questions métier auxquelles une initiative d’IA doit répondre avant que toute donnée ne soit collectée ou chargée. Pour les charges de travail en IA, cette étape est particulièrement importante car elle détermine les résultats que les modèles sont censés produire — prévisions de la demande, prédictions de fraude, scores de propension client — et fonctionne à rebours selon les données requises par ces résultats. Un modèle conceptuel solide empêche les équipes d’entraîner des modèles précis sur les mauvaises questions.
Modélisation logique
La modélisation logique traduit le modèle conceptuel en une structure normalisée, indépendante de la plateforme, composée d’entités, d’attributs et de relations. Pour l’IA, l’intégrité du modèle logique a un impact direct sur la qualité des données d’entraînement : des définitions incohérentes entre les systèmes sources deviennent des caractéristiques incohérentes entre les modèles. Un modèle logique bien conçu fournit une définition unique et autoritaire de chaque entité — client, transaction, actif — que les systèmes d’IA peuvent consulter sans ambiguïté.
Modélisation physique
La modélisation physique détermine comment le modèle logique est stocké, partitionné et accessible sur une plateforme spécifique. Pour les charges de travail en IA, la conception physique comporte deux exigences au-delà de l’analytique traditionnelle : entraîner des tâches qui analysent de grands volumes de données historiques à haut débit, et des charges d’inférence nécessitant des recherches de fonctionnalités à faible latence. Le modèle physique est l’endroit où les décisions concernant le calcul dans la base de données, la stratégie de partitionnement et le format de stockage se traduisent directement par la rapidité d’entraînement du modèle et le coût d’inférence.
Modélisation des caractéristiques
La modélisation des caractéristiques est la couche spécifique à l’IA. Il définit les variables dérivées — caractéristiques, embeddings et représentations vectorielles — que les algorithmes d’apprentissage automatique consomment réellement. Une fonctionnalité peut être une moyenne mobile sur sept jours des transactions d'un client, un embedding vectoriel du texte d'un ticket de support, ou un encodage catégorique d'une hiérarchie produit. La modélisation des caractéristiques formalise la manière dont ces structures dérivées sont nommées, calculées, stockées et réutilisées entre modèles, généralement dans un magasin de caractéristiques. Sans cela, les organisations se retrouvent avec des dizaines d’équipes recalculant indépendamment les mêmes fonctionnalités — une taxe cachée sur la productivité de l’IA et une cause majeure de comportement incohérent des modèles.
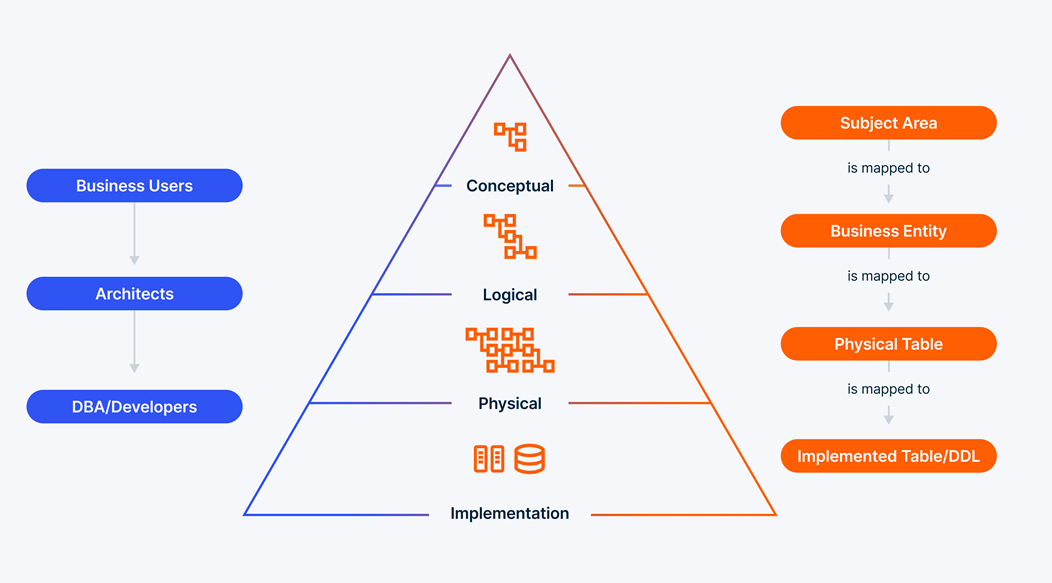 Source : https ://www.theregister.com/2007/06/14/data_modelling_layers/
Principes clés de la modélisation des données pour l’IA
Les principes de la modélisation des données pour l’IA étendent les fondamentaux de la modélisation traditionnelle avec des exigences spécifiques à l’apprentissage automatique et aux charges de travail en IA générative. Cinq principes séparent systématiquement les données d’entreprise prêtes pour l’IA des données d’entreprise à usage général.
Qualité des données et lignée
Les modèles d’IA amplifient la qualité — ou les défauts — des données sur lesquelles ils s’entraînent. Les erreurs qu’un rapport d’intelligence économique absorberait avec une inexactitude mineure deviennent des biais systématiques dans un modèle de production. La modélisation des données par IA considère la qualité et la lignée des données comme des exigences de conception de premier ordre plutôt que comme un nettoyage en aval. Cela signifie intégrer la lignée dans le modèle lui-même : chaque fonctionnalité et chaque jeu de données d’entraînement peuvent être retracés jusqu’aux systèmes sources, aux transformations appliquées, et au moment où les données ont été capturées.
Ingénierie des caractéristiques et réutilisation
Le travail le plus coûteux en IA n’est pas d’entraîner des modèles ; C’est l’ingénierie des fonctionnalités que ces modèles consomment. La modélisation des données par IA établit des définitions partagées et gouvernées des fonctionnalités afin que plusieurs modèles — et plusieurs équipes — puissent les réutiliser sans duplique. Les magasins de fonctionnalités, les conventions de nommage cohérentes et la logique de transformation partagée transforment les fonctionnalités en un atout organisationnel plutôt qu’en une dépense par projet.
Échelle et performances dans la base de données
Les charges de travail en IA d’entreprise fonctionnent sur des volumes de données qui rendent le mouvement traditionnel de données impraticable. Déplacer des téraoctets de données d’entraînement entre l’entrepôt, un environnement d’ingénierie des fonctionnalités et un cluster d’entraînement introduit des problèmes de latence, de coût et de reproductibilité. Un modèle de données d’IA bien conçu est conscient du calcul : il supporte l’ingénierie de fonctionnalités dans la base de données, la formation et le scoring autant que possible, en maintenant les données stationnaires et en laissant le calcul s’exécuter là où elles se trouvent déjà.
Explicabilité et traçabilité
L’explicabilité du modèle est devenue une exigence courante, mais l’explicabilité des données est tout aussi importante et souvent négligée. La modélisation des données par IA permet de répondre à une question fondamentale mais cruciale : quelles données ont entraîné ce modèle, quand et à partir de quelle source ? C’est la base de la gouvernance du modèle, de la réponse réglementaire et de la capacité à reproduire les résultats des mois ou des années après le déploiement d’un modèle.
Alignement industriel
Les modèles de données à usage général obligent les entreprises à reconstruire les mêmes structures fondamentales — client, produit, transaction, réclamation, événement réseau — pour chaque initiative d’IA. Aligner le modèle de données sur un plan industriel éprouvé fait s’effondrer ce coût initial et offre aux équipes d’IA un schéma validé sur lequel s’appuyer dès le premier jour.
Modélisation des données traditionnelle vs. modélisation des données par IA
La modélisation traditionnelle des données et la modélisation des données IA partagent les mêmes pratiques fondamentales, mais elles divergent sur plusieurs dimensions qui comptent pour la manière dont les données d’entreprise sont construites, gouvernées et consommées. Le tableau ci-dessous résume les principales différences.
La modélisation traditionnelle des données reste essentielle pour les rapports, les applications et l’analytique gouvernée. La modélisation des données par IA ne la remplace pas — elle étend la même base pour répondre aux exigences supplémentaires de l’apprentissage automatique et des charges de travail en IA générative.
Considérations d’entreprise pour la modélisation des données par IA
Les entreprises sont confrontées à un ensemble de défis en modélisation des données par IA qui n’apparaissent pas dans des environnements à petite échelle ou des terrains émergents. Les traiter tôt détermine si les initiatives d’IA évoluent ou stagnent.
- Dette de schéma hérité. La plupart des entreprises ont déjà des décennies d’investissement dans des modèles de données opérationnels et analytiques. Les initiatives d’IA justifient rarement de reconstruire ces initiatives à partir de zéro. La voie pratique consiste à étendre les modèles existants avec des couches spécifiques à l’IA — définitions de caractéristiques, vues d’entraînement, extensions vectorielles — plutôt que de les remplacer.
- Modélisation structurée hybride et vectorielle. Les charges de travail d’IA d’entreprise nécessitent régulièrement à la fois des données structurées traditionnelles (enregistrements clients, transactions, hiérarchies produits) et des données vectorielles (incorporations de texte, représentations d’images). Un modèle de données d’IA moderne doit intégrer les deux paradigmes dans une structure unique et cohérente, plutôt que de les traiter comme des systèmes séparés.
- Transmission des données d’entraînement tout au long du cycle de vie de l’IA. Les industries réglementées exigent de plus en plus que les organisations répondent, à la demande, exactement sur quelles données un modèle de production a été entraîné. La lignée des données d’entraînement ne peut pas être modifiée après le déploiement ; Il doit être intégré au modèle de données dès le départ.
- Des jointures organisationnelles entre l’ingénierie des données et la science des données. Dans la plupart des entreprises, les data engineers possèdent le modèle de données et les data scientists possèdent les fonctionnalités. Sans définitions partagées ni transferts gouvernés, les fonctionnalités s’éloignent de leurs données sources, les modèles deviennent inreproductibles, et les équipes gaspillent des cycles à rapprocher les versions. La modélisation des données par IA formalise l’interface entre les deux disciplines.
Modèles de données industriels comme accélérateurs d’IA
La plupart des entreprises reconstruisent 60 % à 70 % de leur modèle de domaine à partir de zéro pour chaque nouvelle initiative d’IA. Les modèles de données industriels préconstruits éliminent ce coût de départ en fournissant un plan validé, en troisième forme normale, de la manière dont les données sont organisées dans une industrie spécifique.
Teradata fournit des modèles de données sectoriels développés à partir de décennies d’engagements d’entreprise et validés auprès des clients dans chaque secteur :
- Teradata Financial Services Logical Data Model (FSLDM) — un plan complet pour la banque, l’assurance et les marchés de capitaux couvrant les domaines clients, produits, transactions et risques.
- Teradata Communications Data Model (CDM) — un modèle spécifique aux télécommunications couvrant les données d’abonnés, de réseau, d’utilisation et de facturation.
- Teradata Healthcare Industry Data Model — un modèle conçu pour les données des payeurs, des fournisseurs et des sciences de la vie.
Utilisés comme accélérateurs, ces modèles de données industriels raccourcissent le temps de valeur de l’IA de trimestres à semaines en éliminant le travail de modélisation fondamental et en fournissant un point de départ cohérent que les équipes d’ingénierie des données et de data science peuvent étendre ensemble.
Comment Teradata aborde la modélisation des données par IA
L'approche de Teradata pour la modélisation des données IA réunit quatre capacités requises par les charges de travail d'IA d'entreprise : des modèles de données industriels préconstruits comme points de départ, l'ingénierie des fonctionnalités dans la base de données, la formation et le scoring de bout en bout sans déplacement de données, ainsi que la gouvernance et la lignée conçues pour l'IA. Les organisations utilisant cette approche modélisent leurs données une seule fois et les réutilisent dans les charges de travail analytiques, de l’apprentissage automatique et de l’IA générative — en maintenant la cohérence des données, des fonctionnalités et des modèles à travers l’entreprise.
Questions fréquemment posées
Vous avez encore des questions sur la modélisation des données par IA ? Voici des réponses à certaines des questions les plus courantes.
L’IA peut-elle faire de la modélisation des données ?
L’IA peut-elle faire de la modélisation des données ?
Certes, l’IA peut automatiser des portions significatives de la modélisation des données — y compris la génération de schéma, l’inférence de relations et l’ingénierie inverse des bases de données — mais elle ne remplace pas les architectes humains des données. Valider la sémantique métier, faire respecter la gouvernance et aligner le modèle sur des cas d’usage spécifiques nécessitent encore un jugement humain. En pratique, l’IA et les architectes de données travaillent ensemble : l’IA gère le travail mécanique répétitif, les architectes dirigent la stratégie.
Quels sont les quatre types de modélisation des données ?
Quels sont les quatre types de modélisation des données ?
Les quatre types de modélisation des données utilisés en IA sont conceptuel, logique, physique et modélisation des caractéristiques. La modélisation conceptuelle définit les entités et relations commerciales ; la modélisation logique les normalise en une structure indépendante de la plateforme ; La modélisation physique détermine comment ils sont stockés et accessibles ; la modélisation des caractéristiques définit les variables dérivées, les embeddings et les vecteurs que les systèmes d’IA consomment directement.
Quelle est la différence entre la modélisation des données et la modélisation des données par IA ?
Quelle est la différence entre la modélisation des données et la modélisation des données par IA ?
La modélisation traditionnelle des données structure les données pour les applications, les rapports et l’analytique à usage général. La modélisation des données par IA étend cette base avec des fonctionnalités, des embeddings, des structures vectorielles et une lignée de données d’entraînement spécifiquement conçues pour rendre les données d’entreprise consommables par l’apprentissage automatique et les systèmes d’IA générative. Les deux disciplines partagent les mêmes couches conceptuelles, logiques et physiques ; La modélisation des données par IA ajoute un quatrième.
Quel rôle jouent les données historiques dans la modélisation de l’IA ?
Quel rôle jouent les données historiques dans la modélisation de l’IA ?
Les données historiques sont la base de la modélisation IA. Les modèles d’apprentissage automatique apprennent les motifs à partir d’observations passées, et l’étendue, la profondeur et la qualité des données historiques déterminent directement la précision du modèle. La modélisation des données par IA préserve les données historiques avec une précision au moment donné afin que les caractéristiques puissent être reconstituées telles qu’elles existaient au moment de l’entraînement — une exigence pour une IA reproductible, auditable et gouvernée.