
L’IA d’entreprise a atteint un point de transition crucial. La phase initiale de l’IA générative s’est concentrée sur la productivité individuelle — générer du texte, résumer des documents et assister les développeurs. Cependant, la valeur organisationnelle nécessite d’aller au-delà des simples consignes vers une exécution autonome en plusieurs étapes. Ce changement introduit l’IA agente : des systèmes autonomes capables de détecter les états de l’environnement, de raisonner à travers des flux de travail complexes, de planifier des séquences et d’exécuter des actions à travers les systèmes d’entreprise.
Bien que l’intérêt pour les flux de travail agents soit élevé, passer de la preuve de concept à la production reste un obstacle pour les dirigeants informatiques d’entreprise : une étude IDC auprès d’entreprises interrogées a révélé qu’environ 88 % des preuves de concept IA n’atteignent jamais la production. Le déploiement d’agents autonomes à travers des architectures hybrides distribuées présente des défis d’ingénierie et de gouvernance distincts. Atteindre une échelle opérationnelle nécessite une architecture d’IA agentique qui offre un contexte fiable, une gouvernance continue et un calcul haute performance évolutif. Les organisations qui s’appuient sur une base de données unifiée passeront avec succès des chatbots expérimentaux aux agents IA autonomes générateurs de valeur.
Points clés
- L'écart de production : Selon l'étude Arrested Automation de Teradata, 90 % des dirigeants informatiques d'entreprise prévoient d'augmenter leurs investissements dans les agents d'IA, mais seulement 7 % ont mis des agents opérationnels dans des flux de travail en plusieurs étapes de production.
- Contexte plutôt que taille du modèle : L’échelle des paramètres du modèle ne peut pas résoudre la fragmentation du contexte. Les agents IA nécessitent un accès en temps réel à la logique métier, aux relations sémantiques et aux historiques transactionnels.
- Cadre architectural à cinq niveaux : La mise à l’échelle des flux de travail agents nécessite une base structurée englobant connaissances et données, contexte, agents et orchestration, gouvernance et résultats métier.
- Infrastructure de calcul unifiée : Les flux de travail d’agents à forte concurrence nécessitent une séparation dédiée du calcul, utilisant le calcul actif pour l’analyse continue de base et le calcul élastique pour l’échelon dynamique des agents.
Le goulot d’étranglement de l’IA en entreprise : pourquoi les pilotes calent
Les entreprises investissent massivement dans les technologies d’IA, mais l’opérationnalisation des flux de travail autonomes reste difficile. L’étude IDC auprès des entreprises interrogées mentionnée ci-dessus, qui a révélé qu’environ 88 % des preuves de concept de l’IA n’atteignent jamais la production, cite une faible préparation organisationnelle dans les données, les processus et l’infrastructure informatique. Comprendre pourquoi ces initiatives stagnent est essentiel pour les responsables techniques qui conçoivent des architectures évolutives.
Au-delà de l’IA personnelle : le passage à l’IA organisationnelle
La première vague d’adoption de l’IA générative s’est concentrée sur l’IA personnelle — des outils qui rédigent des e-mails, répondent à des questions isolées des utilisateurs ou écrivent des extraits de code. L’IA personnelle fonctionne avec un faible risque systémique ; la supervision humaine valide chaque résultat avant son exécution.
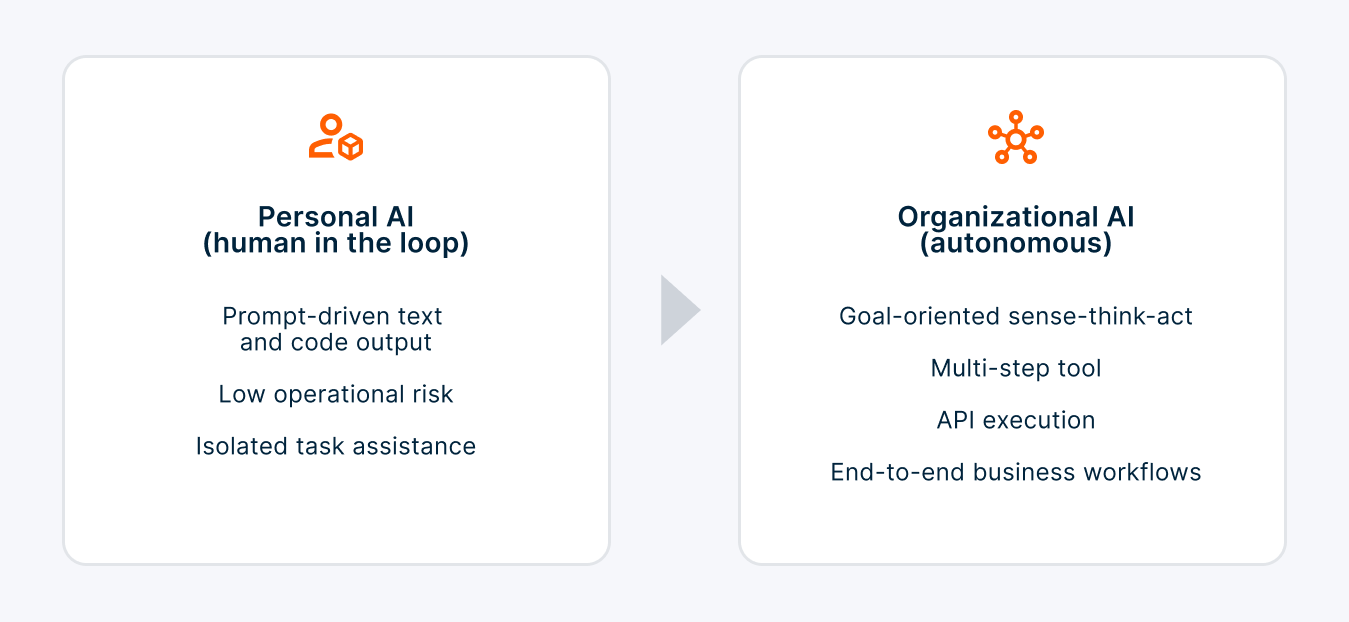
En revanche, l’IA organisationnelle nécessite des agents autonomes qui exécutent des processus métier de bout en bout sans intervention humaine étape par étape. Un agent organisationnel doit interroger les bases de données de l’entreprise, évaluer les contraintes opérationnelles, déclencher des interfaces logicielles externes et enregistrer les transactions. La transition de l’assistance personnelle aux tâches à l’autonomie organisationnelle multiplie la complexité technique. Lorsqu’un agent agit de manière autonome au sein d’un système métier central, une requête hallucinée ou un flux logique incorrect peuvent perturber les opérations de l’entreprise.
Contexte des données et déficits de gouvernance
La cause principale des échecs des pilotes agents n'est pas l'intelligence modélistique ; c'est la fragmentation du contexte et la gouvernance faible. La recherche Arrested Automation de Teradata — une enquête Wakefield Research auprès de 1 000 dirigeants seniors en technologie et en données, commandée par Teradata et déployée au printemps 2026 — révèle des informations cruciales sur la préparation des entreprises.
- Forte intention d’investissement : 90 % des responsables IT et des données prévoient d’augmenter leurs investissements en IA agente au cours des 12 prochains mois.
- Rendement financier limité : 63 % déclarent avoir obtenu peu ou pas de rendement financier mesurable grâce aux mises en œuvre actuelles des agents d’IA.
- Faible préparation opérationnelle : seulement 7 % ont déployé avec succès des agents autonomes dans les processus métier de production.
- L’écart de contexte : 77 % rapportent que 20 % ou moins de leurs données globales d’entreprise sont suffisamment contextualisées et structurées pour la consommation des agents d’IA.
Lorsque les agents autonomes sont construits sur des silos de données déconnectés, ils manquent de la conscience opérationnelle nécessaire pour prendre des décisions précises. Sans une lignée unifiée des données, des contrôles d’accès granulaires et un contexte sémantique en temps réel, les agents d’entreprise génèrent des résultats peu fiables, bloquant les déploiements lors de la phase d’essai.
Le plan directeur de l’architecture d’IA agente en cinq couches
Pour combler le fossé entre les programmes pilotes et les systèmes de production, les équipes techniques ont besoin d’un plan architectural unifié. En termes d’entreprise, l’architecture d’IA agentique est la conception du système qui donne aux agents autonomes un accès aux connaissances, au contexte et aux outils afin qu’ils puissent exécuter un travail en plusieurs étapes — et en être tenus responsables. Le modèle suivant en cinq couches constitue la base structurelle.
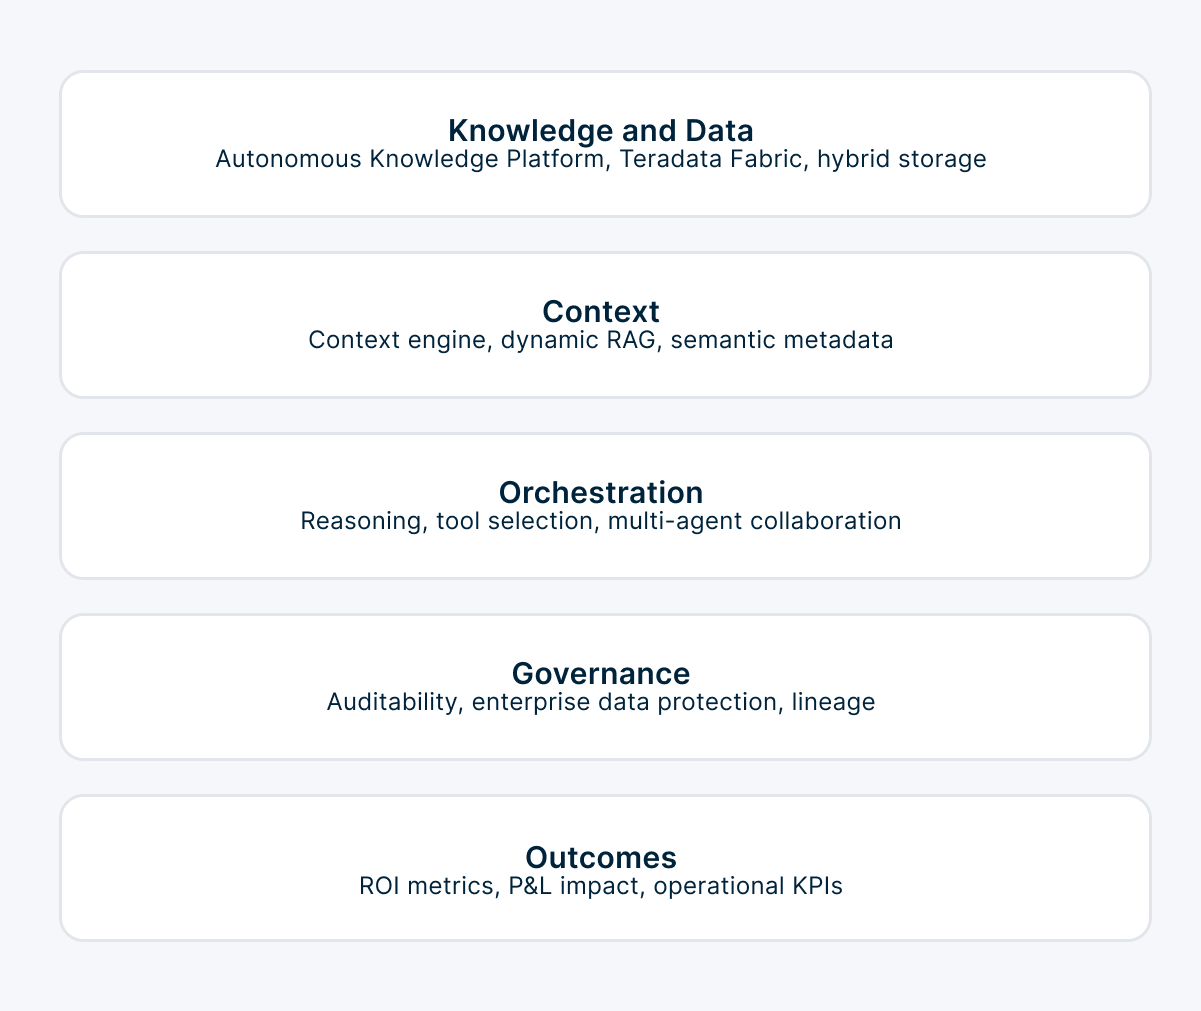
1. Couche de connaissances et de données
La base de tout système agent est la couche de données. Le raisonnement autonome nécessite un accès immédiat aux enregistrements transactionnels, aux métriques historiques, aux embeddings vectoriels et aux fichiers d’entreprise non structurés.
Dans cette couche, Autonomous Knowledge Platform offre un traitement relationnel à haut débit combiné à des capacités de gestion vectorielle. Plutôt que d’exporter de grands ensembles de données dans des bases de données vectorielles externes — ce qui introduit la latence de synchronisation et des vulnérabilités de sécurité — les organisations utilisent directement des fonctionnalités de traitement vectoriel intégré à la base de données et des fonctionnalités d’analytique avancées.
L’intégration des données à travers des environnements cloud hybrides est assurée par Teradata Fabric, qui permet la virtualisation zéro copie des données, permettant aux agents autonomes d’interroger des entrepôts de données distants sans déplacement coûteux des données. En maintenant les données unifiées à la base, les agents fonctionnent sur une seule source de vérité.
2. Couche de contexte
Les données seules sont insuffisantes pour la prise de décision autonome ; les agents nécessitent un contexte opérationnel. Le contexte fournit les règles sémantiques, les politiques de sécurité, la logique métier et les correspondances de relations qui transforment les données brutes en connaissances exploitables pour l’entreprise.
La couche de contexte utilise un moteur de contexte pour assembler dynamiquement le contexte métier pertinent pour les prompts d’agent. Le moteur de contexte synthétise les métadonnées opérationnelles, les sessions utilisateur actives, les définitions de schéma et les règles de domaine avant qu’un agent n’exécute un plan. En ancrant les prompts d’agent dans un contexte d’entreprise en temps réel, les organisations réduisent les hallucinations et maintiennent les actions des agents conformes aux règles organisationnelles.
3. Agents et couche d’orchestration
Les agents et la couche d’orchestration fonctionnent comme le moteur de raisonnement de l’architecture. Cette couche gère la décomposition des tâches, la planification en plusieurs étapes, la sélection des outils et la surveillance de l’exécution.
Dans cette couche, les développeurs utilisent Teradata AI Studio pour construire, tester et déployer des flux de travail agents personnalisés, avec des modèles d’agents, des cadres d’intégration de modèles et une surveillance d’orchestration. Lorsque des tâches complexes nécessitent une collaboration multi-agents, les protocoles d’orchestration divisent la charge de travail :
- Les agents de planification divisent les objectifs métier de haut niveau en sous-tâches séquentielles.
- Les agents d’exécution interagissent avec les routines de base de données, exécutent des interfaces logicielles et font des analyses de processus.
- Les agents de vérification valident les sorties intermédiaires selon les règles de conformité de l’entreprise avant l’exécution finale.
Cette division structurée du travail maintient une exécution autonome déterministe, auditable et alignée sur les politiques du système.
4. Couche de gouvernance et d’auditabilité
L’exécution autonome exige une gouvernance opérationnelle continue. Si un agent modifie les dossiers financiers, redirige les commandes de la chaîne d’approvisionnement ou ajuste les paramètres du compte client, chaque étape de décision doit être entièrement auditable. La couche de gouvernance applique des contrôles de sécurité sur toutes les actions de l’agent.
- Accès aux données zéro confiance : Les agents héritent des permissions et contrôles d’accès au niveau utilisateur en appliquant les principes de moindre privilège.
- Suivi complet de la lignée : chaque invite, chaque charge utile contextuelle récupérée, chaque état de raisonnement intermédiaire et chaque opération de base de données sont enregistrés.
- Sécurité et résilience des données : Teradata Enterprise Data Protection fournit une sauvegarde continue, une récupération au moment précis et la protection des données pour les états d’agent persistants et les tables opérationnelles.
Si un agent rencontre un état non vérifié ou une erreur d’exécution, le cadre de gouvernance arrête le flux de travail et transmet la décision à un superviseur humain.
5. Couche des résultats et de la réalisation de la valeur
La couche supérieure relie l’exécution des agents aux indicateurs clés de l’entreprise. Les systèmes autonomes doivent offrir un impact métier mesurable, tel qu’une latence opérationnelle réduite, des coûts de traitement manuels réduits ou une augmentation de la capture des revenus. En liant directement l’exécution des agents aux indicateurs de performance, les organisations établissent un retour sur investissement financier clair. Teradata Cloud fournit une journalisation opérationnelle, permettant aux équipes d’ingénierie de suivre l’utilisation des ressources, les coûts de requête et les temps d’exécution des agents, ainsi que les indicateurs clés de performance métier.
Risques et stratégies d’atténuation de l’IA agente d’entreprise
Le déploiement de systèmes autonomes introduit des risques opérationnels que les architectures logicielles traditionnelles ne rencontrent pas. Traiter ces risques nécessite des protections architecturales spécifiques.
| Catégorie de risque | Impact opérationnel | Stratégie d’atténuation |
|---|---|---|
| Hallucinations d’agents | Une récupération incorrecte des données entraînant des actions commerciales invalides. | Construction de requêtes au sol à l’aide d’un moteur de contexte ; appliquer des contraintes strictes de schéma dans la base de données. |
| Augmentation des coûts et du calcul | Exécution de boucles itératives incontrôlées menant à une utilisation inattendue du calcul. | Imposez des limites d’appels et alignez un traitement analytique lourd via le calcul élastique. |
| Confidentialité des données et fuite | Des agents exposant des données sensibles des clients au-delà des limites d’autorisation. | Appliquer des politiques d’accès basées sur les rôles au niveau de la plateforme et enregistrer la lignée complète de l’exécution. |
| Défaillances en cascade des systèmes | Une sortie sous-agent défectueuse corrompant les flux de travail en aval de l’entreprise. | Implémentez des portes de validation dans Teradata AI Studio et imposez des routines de secours déterministes. |
Cas d’utilisation réels et à forte valeur ajoutée de l’IA d’agent d’entreprise
Les entreprises déploient des architectures agents pour automatiser des flux de travail complexes et à forte concurrence entre secteurs.
Détection autonome d’anomalies dans les télécommunications
Les réseaux de télécommunications modernes génèrent d’énormes flux de données télémétriques à travers l’infrastructure réseau 5G, et la gestion manuelle de la stabilité du réseau nécessite des ressources opérationnelles importantes. Le déploiement de l’IA agente dans les télécommunications permet aux opérateurs d’automatiser la détection et la résolution des anomalies.
- Sens : Les agents autonomes surveillent les schémas de trafic réseau en temps réel à travers les nœuds distribués en utilisant des analyses natives dans la base de données au sein de la base de données unifiée.
- Pensez : lorsque des anomalies de trafic surviennent, l’agent interroge les journaux de maintenance historiques et les bases de performance à l’aide d’un moteur de contexte pour identifier la cause profonde.
- Agir : L’agent déclenche des appels API pour rediriger le trafic réseau autour de commutateurs congestionnés tout en générant un rapport d’incident pour les ingénieurs réseau.
Analyse automatisée de la conciliation financière et de la variance
Les organisations de services financiers traitent de grands volumes de transactions quotidiennes de registre à travers des unités commerciales mondiales, et les méthodes traditionnelles de rapprochement par lots mettent souvent plusieurs jours à identifier les variations de solde. Une approche agentique automatise l’enquête sur les variances.
- Un agent surveille les registres de transactions gérés au sein de la plateforme de données unifiée.
- En détectant une anomalie comptable, l’agent initie un raisonnement en plusieurs étapes pour isoler la transaction d’origine, interroger les enregistrements de contrepartie via Teradata Fabric et évaluer les règles de conformité réglementaire actuelles.
- L’agent génère une saisie du registre rapproché et un journal d’audit rédige, présentant les conclusions à un contrôleur pour approbation.
Opérationnaliser l’IA agente avec Teradata
Le déploiement de flux de travail autonomes d’agents à l’échelle de l’entreprise nécessite une infrastructure de données haute performance qui équilibre l’analyse continue en arrière-plan avec des pics de calcul dynamiques et imprévisibles.
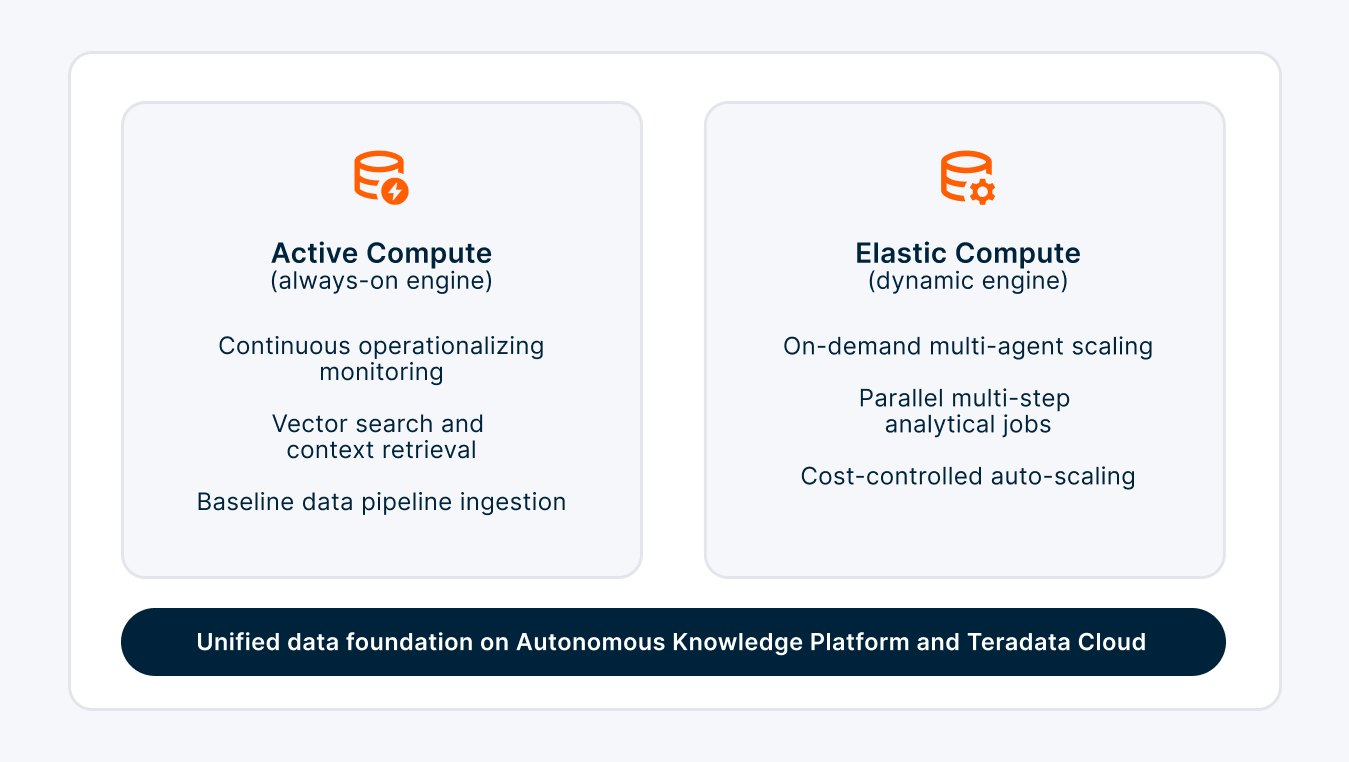
Teradata Cloud fournit les bases du déploiement agent d’entreprise grâce au traitement de calcul à double moteur :
- Calcul actif : offre des performances permanentes et à haute concurrence pour l’ingestion de données de base, la surveillance continue et les opérations de recherche vectorielle en temps réel.
- Calcul élastique : prévoit un calcul analytique à la demande lorsque les agents initient des tâches complexes de raisonnement en plusieurs étapes ou des opérations de données parallèles, soutenant une gestion des coûts prévisible.
Les développeurs utilisent Teradata AI Studio pour modéliser, tester et surveiller les flux de travail multi-agents, ainsi que Teradata Fabric, qui offre un accès aux données sans copie à travers des environnements cloud. En intégrant la gestion du contexte, le calcul flexible et la gouvernance d’entreprise, Teradata aide les organisations à faire passer les initiatives d’agents IA des essais expérimentaux à l’échelle de la production.
Conclusion
Le paysage de l’IA d’entreprise évolue rapidement des interfaces d’assistants passifs aux systèmes agents opérationnels. Les organisations qui s’appuient sur des solutions ponctuelles isolées ou des modèles de langage non ancrés continueront de rencontrer des difficultés face au blocage des pilotes et à la gouvernance fragmentée des données. La mise à l’échelle des agents IA autonomes nécessite une base architecturale solide — qui unit pipelines de données, contexte sémantique, gouvernance continue et calcul flexible. En adoptant une architecture structurée à cinq couches, les dirigeants techniques peuvent combler le fossé pilote-production, atténuer les risques opérationnels et libérer la valeur durable de l’entreprise grâce à l’IA autonome.
Accélérez le déploiement de votre IA agente
Prêt à faire passer vos agents d’IA d’entreprise du pilote à la production ? Découvrez comment la plateforme autonome de connaissance Teradata peut unifier vos données, ancrer vos agents dans un contexte temps réel et adapter en toute sécurité les flux de travail de l’entreprise. Demandez une démonstration personnalisée ou commencez une évaluation pratique avec un essai Teradata.