Aperçu
La transformation des données est le processus de conversion des données d’un format, d’une structure ou d’un schéma en un autre — nettoyage, standardisation, agrégation et cartographie des données brutes en une forme cohérente et haute fidélité en laquelle les modèles d’analytique en aval, d’intelligence économique (BI) et d’intelligence artificielle (IA) peuvent avoir confiance.
Dans les environnements d’entreprise modernes, les données brutes proviennent de systèmes fragmentés dans des structures diverses : journaux opérationnels non structurés, enregistrements transactionnels, télémétrie de capteurs IoT et charges utiles JSON semi-structurées. Laissés non affinés, ces flux disparates créent des silos de données, cassent des pipelines analytiques en aval et introduisent des biais dans les systèmes d’apprentissage automatique. Les données d’enquête indiquent que les équipes d’ingénierie des données consacrent régulièrement jusqu’à 80 % de leurs cycles opérationnels à la préparation et à la transformation manuelles des données plutôt qu’à la modélisation à forte valeur.
En établissant des pipelines automatisés et évolutifs de transformation des données, les organisations élèvent les entrées brutes multi-sources en actifs de données de qualité entreprise. Ces actifs propres et structurés alimentent des tableaux de bord en temps réel, des algorithmes prédictifs, l’ingénierie des fonctionnalités pour l’IA générative et le reporting réglementaire. Reconnu comme un leader dans The Forrester Wave™ : Data Management for Analytics Platforms, deuxième trimestre 2025 — obtenant le score le plus élevé possible (5/5) en transformation de données, intégration des données et analyse en plateforme — la plateforme Teradata fournit la base haute performance nécessaire pour traiter des charges de travail complexes de transformation à grande échelle en utilisant les capacités analytiques standard de la base de données Teradata.
Points clés
- La transformation des données standardise et restructure les données brutes en un actif uniforme et de haute qualité pour les modèles d’analytique, de BI et d’apprentissage automatique.
- Le pipeline fondamental suit cinq étapes clés : collecte, nettoyage, normalisation, agrégation et cartographie.
- Les architectures cloud modernes privilégient de plus en plus l’ELT (extract, load, transform), exploitant une puissance de calcul massive dans la base de données pour transformer les données directement dans Teradata Cloud.
- Les outils flexibles vont des langages open source (Python, R, SQL) aux frameworks ELT dédiés (comme Teradata sur dbt Cloud) et aux capacités natives dans la base de données Teradata Database.
- Les transformations à fort impact alimentent des flux de travail critiques en matière de conformité financière, d’interopérabilité dans la santé, d’analyse client de la distribution et de BI exécutive.
Processus de transformation des données
Le processus de transformation des données englobe plusieurs tâches coordonnées qui transforment les données brutes et non raffinées en une ressource structurée et hautement fiable. Bien que les implémentations individuelles dépendent de l’architecture d’entreprise et des objectifs métier, la plupart des flux de travail de transformation haute performance suivent un ensemble d’étapes fondamentales dans la transformation des données. Chaque étape s’exécute au sein d’un pipeline de données plus large qui déplace les enregistrements du système source vers la cible analytique.
1. Collecte de données
Les données brutes sont extraites des environnements sources — y compris les bases de données CRM, les systèmes ERP, les API web, le stockage cloud et les plateformes de streaming. Parce que ces entrées arrivent sous forme hétérogène (tables SQL, CSV, JSON, XML), la collecte initiale établit la connexion de base pour le traitement en aval. Consolider ainsi des sources hétérogènes est ce qui rend possible la transformation en aval intégrée à l’échelle de l’entreprise.
2. Nettoyage des données
Le nettoyage traite le bruit structurel et les erreurs dans les ensembles de données bruts. Durant cette phase, des règles automatisées identifient et corrigent les champs incomplets, éliminent les enregistrements en double, réconcilient les valeurs conflictuelles et gèrent les données manquantes. Pour explorer comment les protocoles automatisés de nettoyage et de validation protègent la fiabilité des pipelines, lisez notre guide détaillé sur ce qu’est le nettoyage des données.
3. Normalisation des données
La normalisation standardise les valeurs de données à travers des systèmes disparates afin qu’elles puissent être comparées et reliées avec précision. Les méthodes courantes incluent le reformatage des horodatages selon les normes ISO, la conversion des valeurs de devises, la redimensionnement des plages numériques pour l’apprentissage automatique (par exemple, l’échelle min-max ou la normalisation z-score), et l’alignement des définitions de code (par exemple, la correspondance de « US », « USA » et « United States » à une seule norme).
4. Agrégation des données
L’agrégation synthétise des données granulaires au niveau des enregistrements en statistiques résumées adaptées aux rapports et aux tableaux de bord exécutifs. Les opérations incluent le calcul des totaux de ventes quotidiens, la moyenne des temps de réponse client par région, ou le calcul des volumes de transactions mobiles sur 30 jours.
5. Cartographie des données
La cartographie des données définit les relations précises au niveau du champ entre les attributs du schéma source et les cibles de la base de données de destination. La cartographie établit le plan directeur qui garantit que les champs de données acheminent vers leurs destinations correspondantes exactes lors d’intégrations complexes de systèmes ou de projets de migration de données .
Résumé des méthodes de transformation des données
Pour sélectionner les bonnes méthodes de transformation de données pour votre pipeline, comparez ci-dessous leur fonction principale, leur cas d’usage principal et leur complexité opérationnelle.
| Méthode de transformation | Ce que ça fait | Quand l’utiliser | Exemple | Complexité |
|---|---|---|---|---|
| Nettoyage des données | Supprime les erreurs, les doublons et les enregistrements invalides | Avant de charger ou d’analyser des données brutes non fiables | Correction des adresses mal orthographiées et suppression des identifiants clients en double | Bas-moyen |
| Normalisation des données | Standardise les formats, les plages et les échelles métriques | Préparation de jeux de fonctionnalités pour des bases de données, des modèles de BI ou d’IA | Standardisation des formats de dates à YYYY-MM-DD ou mise à l’échelle entre 0 et 1 | Moyen |
| Agrégation de données | Résume des dossiers détaillés en indicateurs d’affaires | Construire des tableaux de bord exécutifs, des KPI et des couches de reporting | Somme des transactions horaires en magasin en chiffres hebdomadaires régionaux de revenus | Low |
| Cartographie des données | Relie les champs sources aux attributs du schéma cible | Intégration des systèmes, consolidation de schémas et migrations | Faire correspondre cust_num en CRM avec Account_ID en ERP | Moyen |
| Enrichissement des données | Ajoute des données externes ou contextuelles | Renforcer la profondeur analytique et la segmentation des clients | Ajout d’attributs démographiques ou de géolocalisation aux profils utilisateurs | Moyen-élevé |
En production, les équipes d’ingénierie combinent fréquemment ces méthodes dans des modèles plus larges d’orchestration des flux de travail de données afin de maintenir une intégrité continue des pipelines.
Transformations de données en ETL et ELT
La transformation des données est un élément central à la fois dans les architectures d’extraction, de transformation et de chargement (ETL) et d’extraction , chargement et transformation (ELT) — les schémas fondamentaux de l’intégration moderne des données.
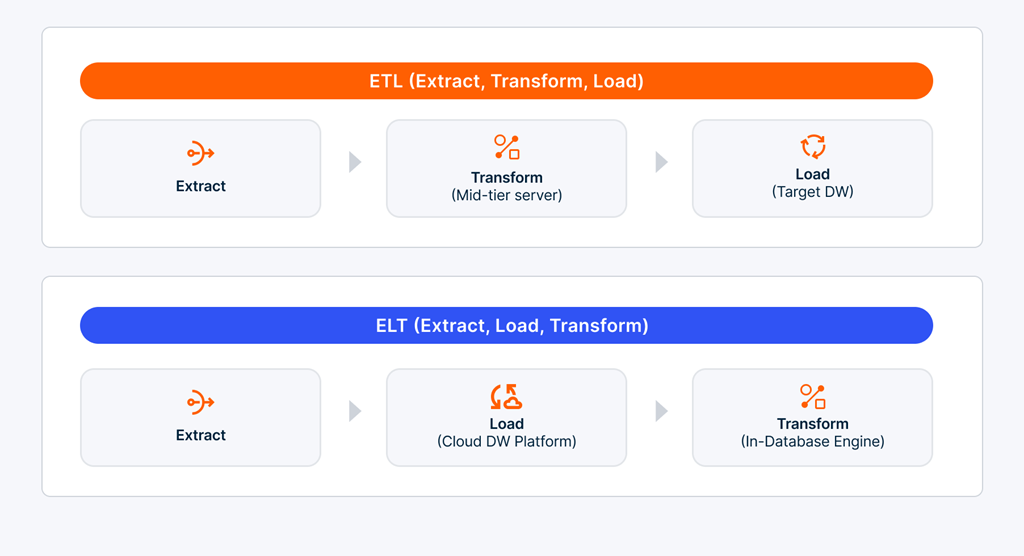
L’approche traditionnelle ETL
Dans les pipelines ETL classiques, la transformation des données a lieu sur un serveur de staging intermédiaire après extraction des systèmes sources, mais avant le chargement dans l’entrepôt de données cible.
- Points forts : Garantit une qualité stricte des données, une gouvernance et une mise en forme de conformité avant que les données brutes n’atteignent un stockage permanent.
- Mieux utilisé pour : Architectures on-premises héritées, ensembles de données sensibles nécessitant une anonymisation stricte avant le chargement, et cadres de conformité rigides.
L’approche moderne de l’ELT
Avec l’évolution des plateformes de données cloud, l’ELT est devenu l’architecture dominante pour l’analytique d’entreprise et la préparation de fonctionnalités de l’IA. Dans les pipelines ELT, les données brutes sont extraites et chargées immédiatement dans l’entrepôt de données cloud dans son format d’origine. Les transformations sont ensuite exécutées directement à l’intérieur de la plateforme de données en utilisant une puissance de calcul native et parallélisée.
- Points forts : Offre une grande scalabilité des performances, des temps de chargement plus rapides et des capacités flexibles de schéma en lecture pour les données semi-structurées.
- Mieux utilisé pour : Analyses cloud à haut volume, flux de données non structurées/semi-structurées, analyses en temps réel et ingénierie avancée des fonctionnalités IA/ML.
Le choix de l’ETL ou de l’ELT dépend du volume de données, des besoins en latence du pipeline et de l’infrastructure. Les organisations gérant des flux de travail d’entreprise complexes utilisent souvent l’orchestration de données de bout en bout pour coordonner de manière transparente les tâches hybrides ETL/ELT à travers les réseaux cloud distribués.
Exemple de transformation de données
Pour comprendre la transformation des données en pratique, envisagez un prestataire régional de soins intégrant des indicateurs patients à travers des cliniques disparates, des laboratoires de diagnostic et des logiciels de dossiers médicaux électroniques (DSE).
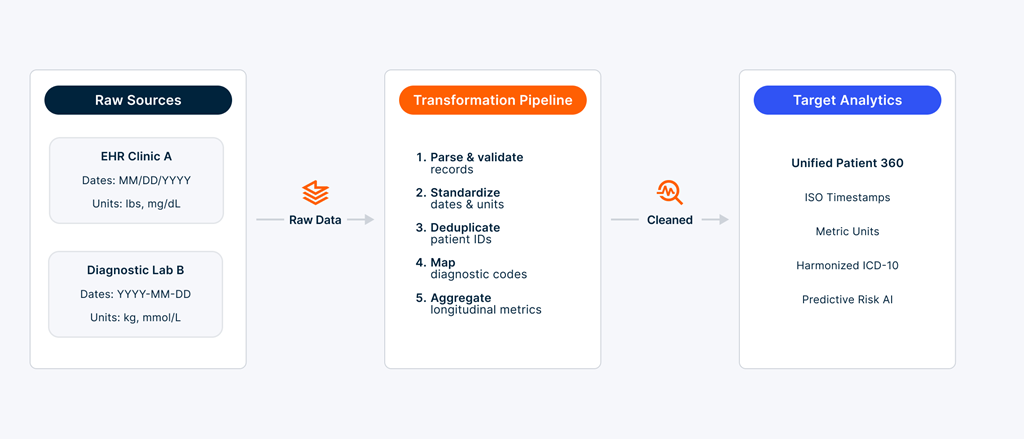
- Extraction : Les tableaux bruts sont extraits de la clinique A (en utilisant des unités de mesure impériales et des dates MM/DD/AAAA) et du laboratoire B (en utilisant des unités métriques et des dates aaa-mm-dd).
- Nettoyage et validation : Les lectures des capteurs hors plage (par exemple, des valeurs négatives d’impulsion) sont signalées et acheminées vers des files d’attente d’exception, tandis que les entrées dupliquées des patients sont fusionnées.
- Normalisation : Toutes les valeurs de poids sont converties en kilogrammes (kg), les mesures de glucose sanguin sont standardisées en mg/dL, et les horodatages correspondent à la norme ISO 8601.
- Cartographie et agrégation : Les codes diagnostiques sont associés aux classifications universelles CIM-10, et les visites cliniques individuelles sont agrégées dans un seul profil longitudinal du patient.
Les résultats offrent aux cliniciens et aux data scientists une vision propre et unifiée de la santé des patients, alimentant directement l’analyse prédictive pour l’intervention précoce en maladies et les assistants cliniques en IA générative.
Meilleures pratiques en matière de transformation des données
- Établir des objectifs métier clairs : Définir les exigences des utilisateurs finaux avant de concevoir des schémas afin d’éviter une surcharge informatique inutile.
- Faire respecter la gouvernance des données dès le début : Maintenir des contrôles stricts de la qualité des données, la consignation des audits et le suivi de la lignée tout au long du cycle de transformation de la transformation.
- Intégrer des tests automatisés : Mettre en place des tests unitaires automatisés et des vérifications de schéma dans le pipeline de transformation pour détecter les anomalies avant qu’elles n’atteignent les rapports de production.
- Profitez du traitement intégré à la base de données : Minimisez les flux coûteux de données en exécutant des transformations directement sur des plateformes de données cloud évolutives.
Avantages de la transformation des données
Une stratégie robuste de transformation des données apporte des bénéfices fondamentaux qui impactent tous les niveaux de l’écosystème de données d’une entreprise.
Amélioration de la qualité et de la cohérence des données
Les données brutes contiennent intrinsèquement des erreurs, des champs redondants et des formats incompatibles. Le nettoyage systématique et la normalisation éliminent ces anomalies, garantissant des entrées cohérentes et de haute fidélité entre les unités métier. Des données de haute qualité réduisent les frictions opérationnelles, atténuent les risques de conformité et établissent une source unique de vérité.
Analyse et prise de décision améliorées des données
Les données transformées permettent aux data scientists et analystes métier d’appliquer des modèles analytiques avancés sans préparation manuelle. Des ensembles de données propres et structurés améliorent directement les performances des algorithmes prédictifs, des tableaux de bord exécutifs et des modèles statistiques. Par exemple, l’application de métriques normalisées simplifie les calculs en aval en statistiques descriptives et en reporting automatisé.
Amélioration de l’efficacité opérationnelle
L’automatisation de la transformation des données élimine les efforts manuels de gestion des données qui consomment jusqu’à 80 % du temps d’une équipe d’analytique. Des pipelines standardisés et automatisés accélèrent la diffusion des informations, réduisent les coûts de traitement et améliorent la performance des requêtes dans les systèmes d’entreprise.
Outils de transformation des données
Le choix du bon logiciel dépend du volume de données, de l’architecture, des compétences et de l’exécution des transformations — des scripts de code des développeurs aux plateformes cloud d’entreprise.
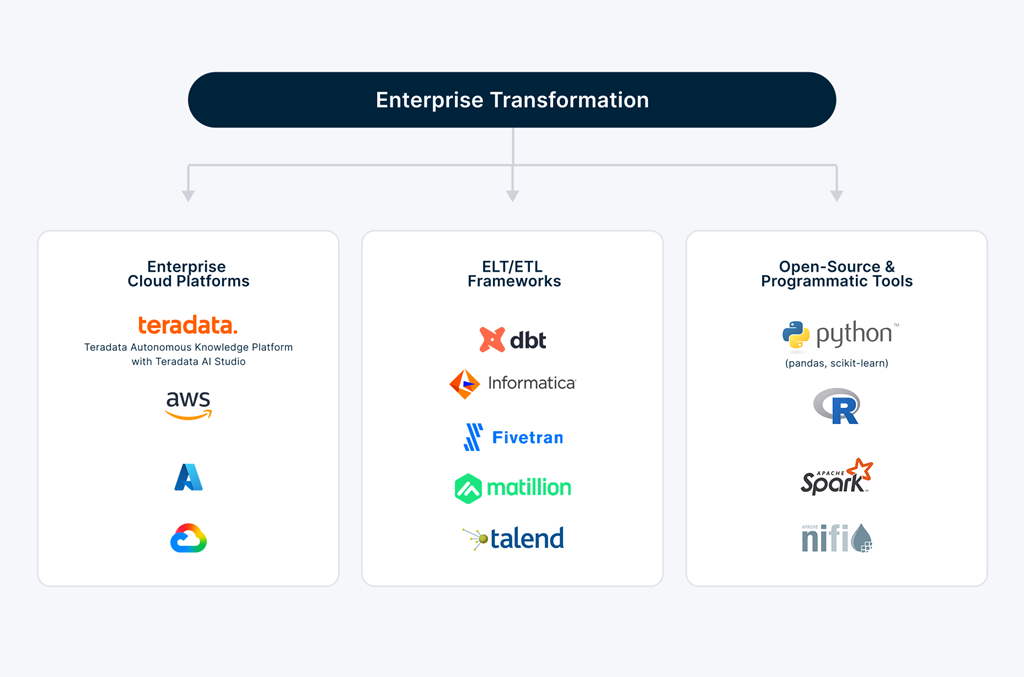
Teradata Cloud et analyses intégrées à la base de données avec Teradata Database
Les architectures d’entreprise modernes privilégient l’exécution directe des transformations au sein de la couche de stockage des données afin d’éviter la latence et les coûts de sortie des données.
- Cloud : En tant qu’environnement de déploiement cloud géré, Teradata Cloud exécute nativement des transformations ELT à grande échelle. Database fournit des fonctions intégrées parallélisées à la préparation des données, à l’ingénierie des fonctionnalités, à l’analyse de texte et à la génération de vecteurs — réalisant des transformations complexes directement là où résident les données sans extraction externe.
- Écosystèmes d’infrastructure cloud : Les principales plateformes de données cloud — dont Teradata Cloud, Snowflake, Google BigQuery, Databricks et AWS Redshift — exploitent le calcul intégré à la base de données pour traiter efficacement les pipelines ELT à haut débit.
Cadres spécialisés ETL et ELT
- DBT (Data Build Tool) : Permet aux équipes de données d’écrire des transformations sous forme de requêtes SQL modulaires, soutenant les pratiques modernes d’ingénierie analytique. Avec des intégrations comme Teradata sur DBT Cloud, les équipes peuvent gérer des modèles de transformation contrôlés par version avec une gouvernance de niveau entreprise.
- Informatica, Fivetran, Matillion & Talend : Fournir des connecteurs préconstruits et des interfaces visuelles automatisées pour orchestrer des pipelines complexes d’ingestion et de transformation de données à travers des topologies multi-cloud.
Cadres open source et programmatiques
- Python et R : Fournir un contrôle granulaire pour les tâches de transformation personnalisées. Les bibliothèques Python comme pandas et scikit-learn offrent des fonctions robustes (par exemple, MinMaxScaler, StandardScaler) pour l’ingénierie des fonctionnalités, tandis que R excelle dans la manipulation statistique.
- Apache Spark et Apache NiFi : Fournir une puissance de traitement distribuée pour les transformations de big data, la télémétrie en streaming et les pipelines d’événements à haute vitesse.
Cas d’utilisation industriels
La transformation des données constitue la colonne vertébrale pour l’activation des données spécifiques à chaque secteur.
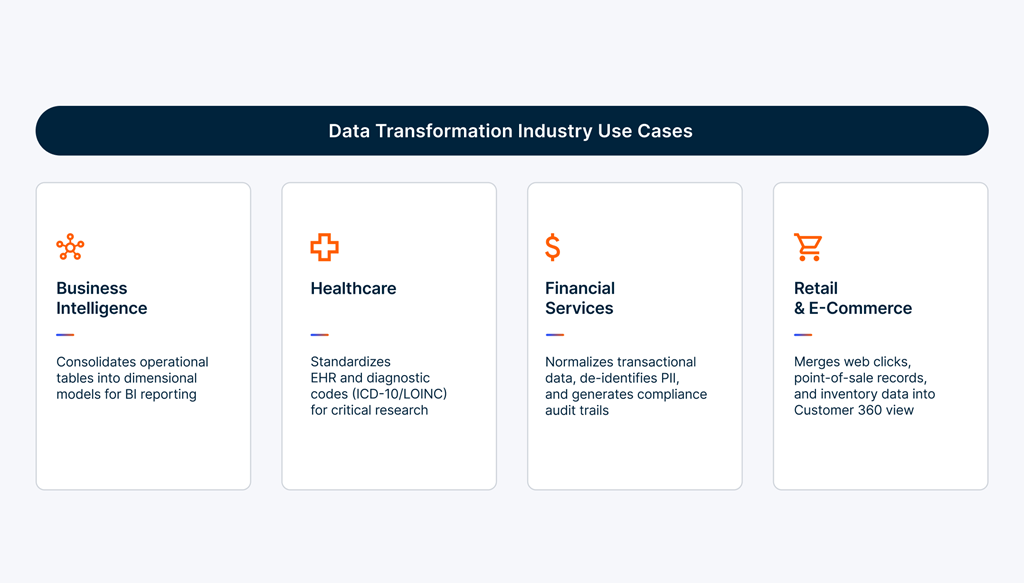
- Intelligence économique : Les journaux opérationnels bruts sont purifiés, agrégés et mappés dans des data marts à schémas étoilés, fournissant aux dirigeants des informations précises et en temps réel sur les KPI de l’entreprise.
- Santé et sciences de la vie : Les dossiers médicaux, résultats de laboratoire et dossiers de facturation provenant de divers fournisseurs de dossiers électroniques sont transformés en formats standardisés (comme le FHIR), permettant une interopérabilité clinique fluide et un suivi des résultats des patients.
- Services financiers : Les institutions financières transforment les flux transactionnels bruts pour détecter en temps réel les activités frauduleuses, normaliser les conversions de devises transfrontalières et compiler des rapports réglementaires automatisés.
- Commerce de détail et e-commerce : Les détaillants combinent des sessions de navigation en ligne, des transactions au point de vente et des mises à jour de la chaîne d’approvisionnement en profils clients unifiés afin d’alimenter des moteurs de recommandation personnalisés et des prévisions dynamiques des stocks.
Conclusion
La transformation des données transforme des données brutes et fragmentées en un atout structuré et fiable — formant la base essentielle de l’intelligence économique moderne, de l’analyse d’entreprise et de l’IA. Alors que les volumes de données d’entreprise continuent d’accélérer dans des environnements multi-cloud, réaliser des transformations de manière efficace et sécurisée à grande échelle est devenu un avantage stratégique essentiel.
En tirant parti des capacités intégrées à la base de données de Teradata Database au sein de Teradata Cloud, les organisations peuvent transformer les données directement là où elles se trouvent — éliminant les déplacements redondants de données, accélérant la performance des pipelines et réduisant la complexité opérationnelle. Pour explorer comment transformer l'architecture de votre pipeline de données ou approfondir l'expertise de votre équipe, consultez les ressources d'analyse intégrées à la base de données de Teradata ou découvrez les parcours d'apprentissage sur Teradata University.
Prêt à moderniser vos charges de travail de transformation d’entreprise ?
Arrêtez de dépenser jusqu’à 80 % de votre bande passante en ingénierie des données en gestion manuelle et en matériel de staging externe coûteux. Modernisez vos pipelines ELT directement dans la couche de base de données pour débloquer un traitement parallèle massif, réduire la surcharge du cloud computing et fournir des ensembles de données prêts pour l’IA en temps réel.
Explorez les solutions d’analyse Teradata dans la base de données ou planifiez une démonstration d’architecture pour voir comment la plateforme Teradata transforme des flux bruts à fort volume en intelligence d’entreprise à grande échelle.
Questions fréquemment posées
Quels sont les principaux types de transformation des données ?
Quels sont les principaux types de transformation des données ?
Les principaux types de transformation des données incluent :
- Transformation constructive : Crée de nouvelles métriques, des champs calculés ou des attributs agrégés à partir de données existantes.
- Transformation destructive : Élimine les champs inutiles, les enregistrements redondants ou les valeurs sensibles (par exemple, la suppression de données personnelles brutes lors du filtrage de conformité).
- Transformation esthétique : Standardise les formats de données, tels que le reformatage des numéros de téléphone, des dates ou des chaînes d’adresses.
- Transformation structurelle : Réorganise les topologies des schémas de base de données, comme pivoter des lignes en colonnes ou aplatir des documents JSON hiérarchiques en tables relationnelles.
Quels sont les risques liés à la transformation des données ?
Quels sont les risques liés à la transformation des données ?
Les principaux risques dans les pipelines de transformation des données incluent :
- Perte ou corruption de données : Des règles de cartographie défaillantes ou une troncature incorrecte lors de la transformation peuvent écraser des enregistrements critiques.
- Goulots d’étranglement de performance : L’exécution de scripts de transformation complexes et non optimisés sur d’énormes ensembles de données peut bloquer les pipelines en aval et gonfler les factures de cloud computing.
- Défaillances de sécurité et de conformité : Exposer involontairement des dossiers sensibles ou ne pas appliquer les fonctions de masquage requises lors du traitement crée des vulnérabilités de gouvernance.
- Dérive du schéma : Des changements non annoncés dans les formats sources en amont peuvent casser les scripts de transformation et corrompre les tables cibles.
Par où devrait-on commencer avec la transformation des données ?
Par où devrait-on commencer avec la transformation des données ?
Pour établir un processus efficace de transformation des données, suivez ces étapes fondamentales :
- Découverte et profilage : Analysez vos sources de données brutes pour identifier les variations de schéma, les erreurs de qualité des données et les valeurs manquantes.
- Cartographie et définition des règles : Définissez les règles métier, les mappages de champs et la logique de transformation avant d’écrire du code.
- Nettoyage et prétraitement des données : Nettoyez les ensembles de données brutes en résolvant les doublons, en standardisant les types de données et en validant les formats à l’aide d’outils comme le nettoyage des données.
- Exécution et orchestration : Chargez et transformez les données à l’aide d’architectures évolutives (comme ELT dans Teradata Cloud) gérées par une orchestration de workflow fiable.
- Surveillance continue : Mettre en œuvre une surveillance automatisée des pipelines pour suivre la dérive des schémas, valider la précision des sorties et maintenir la qualité des données à long terme.